
Comment apparaître dans ChatGPT
ChatGPT nomme une marque par deux voies différentes, de mémoire et par recherche en direct, et chacune exige un travail différent. Le mécanisme, ce qu’il faut faire pour chacune, ce que vous pouvez vérifier sur votre site dès aujourd’hui, et le temps que met chaque voie à bouger.
 Diego MoraesCTO
 Ouvrir dans ChatGPT
 Ouvrir dans Claude
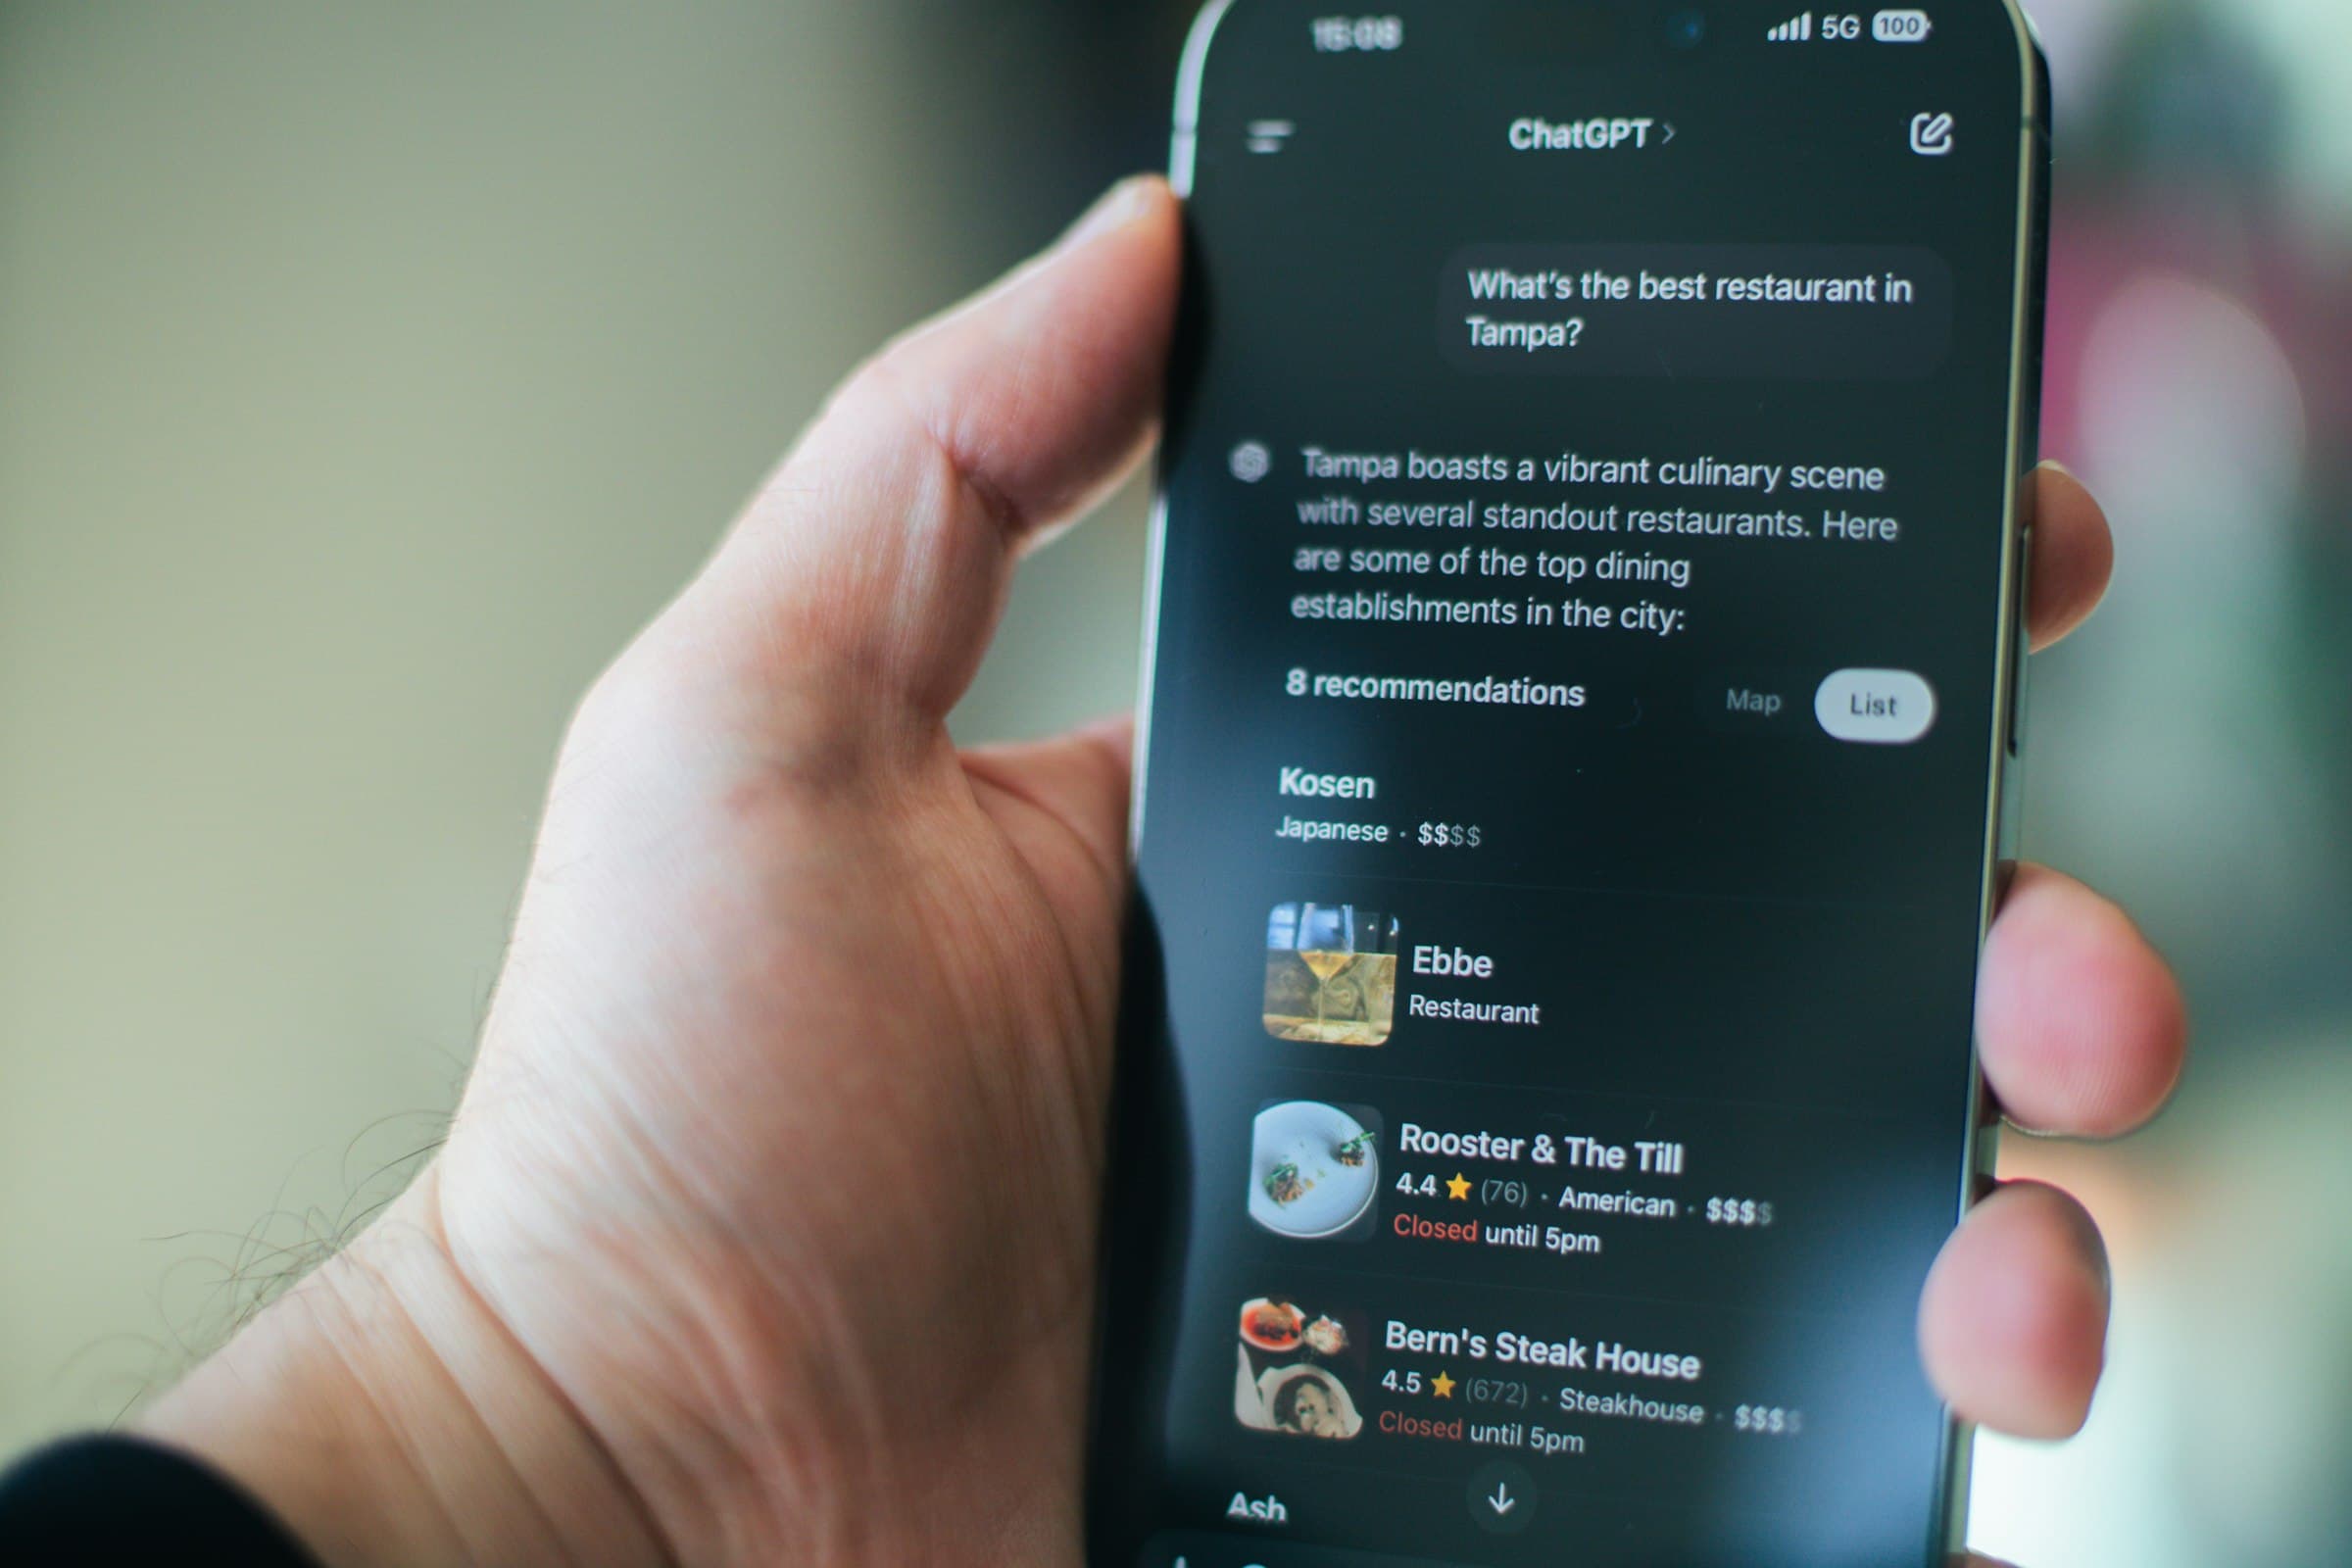
Commencez par ceci, car cela change tout le reste : ChatGPT nomme une marque par deux voies différentes, et l’essentiel de ce qui s’écrit sur le sujet traite les deux comme s’il n’y en avait qu’une.
Les deux voies
De mémoire. Le modèle répond avec ce qui lui est resté de l’entraînement. Il ne va pas sur Internet, ne cite aucun lien, et donne des noms de marques qu’il a appris à associer à un type de besoin. Ici, gagne celui qui est une entité reconnue dans de nombreuses sources indépendantes. Cela change lentement : cela dépend de cycles d’entraînement qui ont lieu quand OpenAI le décide.
Par recherche en direct. La question déclenche une recherche, le modèle lit des pages à ce moment-là et répond en les citant. Ici, gagne celui qui a un contenu trouvable qui répond à la question, et celui qui est présent sur les pages que le moteur choisit de lire. Cela change vite : en semaines, pas en mois.
La conséquence pratique est simple. Si vous avez besoin d’un résultat ce trimestre, travaillez la seconde voie. La première se construit en parallèle et rapporte plus tard, plus longtemps. Nous avons détaillé la différence dans knowledge vs augmented.
Que faire, dans l’ordre
Ouvrir la porte aux deux robots, qui ne sont pas les mêmes
OpenAI utilise des agents distincts aux finalités distinctes. GPTBot collecte du contenu susceptible d’entrer dans de futurs entraînements. OAI-SearchBot récupère des pages au moment où quelqu’un pose une question avec la recherche activée. Bloquer le premier est une décision commerciale défendable. Bloquer le second, c’est choisir de ne pas exister dans les réponses d’aujourd’hui.
À faire : dans le robots.txt, autoriser au minimum OAI-SearchBot. Décider pour GPTBot à tête reposée : si vous vivez du fait d’être trouvé, l’autoriser est en général payant.
Être une entité, pas seulement un site
Le modèle ne stocke pas des pages, il stocke des entités et ce que l’on en dit. Une marque qui n’existe que sur son propre domaine est une affirmation sans confirmation. Une marque inscrite dans des bases de données publiques et dotée de profils cohérents est un fait vérifiable dans plusieurs sources indépendantes, et c’est ainsi qu’elle finit par être nommée de mémoire.
À faire : déclarer sameAs dans le schema de l’organisation en pointant vers des profils qui existent réellement, et veiller à les avoir : une fiche Wikidata, une page LinkedIn d’entreprise, et les annuaires qui comptent dans votre secteur. Nom, adresse et téléphone identiques partout, au caractère près.
Publier ce que vous seul pouvez publier
Un moteur cite celui qui apporte quelque chose. Un texte qui répète ce qui existe déjà sur vingt sites ne donne aucune raison d’être choisi. Des chiffres originaux, une méthodologie déclarée, des cas au résultat vérifiable et des comparaisons honnêtes, y compris avec ceux qui font mieux que vous sur un point, voilà ce qui se distingue parmi des contenus interchangeables.
À faire : choisir une question que votre acheteur pose réellement et y répondre mieux que n’importe quelle autre page dans votre langue. Une par mois vaut plus que quatre génériques.
Être dans les sources que le moteur lit quand il cherche
En mode recherche en direct, ChatGPT n’invente rien : il lit des pages et les cite. Souvent, ces pages ne sont pas les vôtres : ce sont des listes, des comparatifs, des forums et de la presse. Bien apparaître sur ces sites est souvent plus rapide que d’essayer de faire citer votre propre page.
À faire : repérer quelles sources sont citées dans les questions de votre catégorie et travailler votre présence dans chacune, une par une. C’est un travail de relation, pas de code.
Mesurer, car la réponse change sans prévenir
La même question donne des réponses différentes d’une semaine à l’autre, et personne ne vous envoie d’e-mail quand vous cessez d’être cité. Sans mesure répétée, vous ne pouvez pas savoir si le travail a payé, et la discussion repose sur des impressions.
À faire : fixer un ensemble de vraies questions d’acheteurs et les soumettre à cadence régulière, en conservant l’historique. C’est ce que nous faisons, et c’est ce qui permet de dire si une action a fait bouger les choses.
Les vérifications, en deux commandes
Pour que cela ne reste pas théorique, voici ce qui se vérifie avec deux commandes. Remplacez le domaine par le vôtre.
Les deux agents d’OpenAI ont un accès
$ curl -s https://example.com/robots.txt | grep -iA1 'GPTBot\|OAI-SearchBot'

User-Agent: GPTBot
Allow: /
--
User-Agent: OAI-SearchBot
Allow: /
Tous deux autorisés, chacun avec son propre bloc. Si vous n’avez qu’une règle générique avec Disallow, les deux sont exclus et le reste du travail ne compte jamais.
La marque se déclare comme entité
$ curl -s https://example.com/ | grep -o '"sameAs":\[[^]]*\]'

https://www.linkedin.com/company/example
https://www.crunchbase.com/organization/example
https://www.wikidata.org/wiki/Q000000
Des sources indépendantes, et parmi elles Wikidata, celle qui pèse le plus parce qu’elle est lue par pratiquement tous les systèmes qui construisent des graphes d’entités. Un avertissement de quelqu’un qui est passé par là : l’élément Wikidata ne se crée qu’une fois qu’existent des références publiques (presse, études, registres officiels). Un élément sans références est supprimé pour défaut de notoriété, et un sameAs qui pointe vers un élément supprimé est pire que rien. Si cette commande ne renvoie rien, la marque n’existe que par sa propre affirmation.
La vérification complète de la lisibilité du site se trouve dans six commandes pour savoir si l’IA peut lire votre site.
Ce qui ne fonctionne pas
Il n’existe pas de formulaire de soumission pour ChatGPT, pas de panneau de marque, et l’on ne paie pas pour être recommandé dans la réponse organique. Si quelqu’un vous vend une inscription, il vous vend quelque chose qui n’existe pas.
Remplir le site de pages générées ne fonctionne pas non plus, et c’est aujourd’hui contre-productif : un contenu interchangeable est exactement ce qu’un moteur n’a aucune raison de citer. Et déclarer un schema qui ne correspond pas à ce qui figure sur la page se repère, et coûte plus cher que de ne pas avoir de schema du tout.
Questions fréquentes
Non. Il n’existe ni formulaire de soumission, ni panneau d’administration de marque, ni moyen de payer pour être recommandé de façon organique. Celui qui vous vend une inscription dans ChatGPT vous vend quelque chose qui n’existe pas. Ce qui existe : autoriser les agents à lire le site, faire de la marque une entité reconnaissable dans des sources indépendantes, et gagner sa présence sur les pages que le moteur cite lorsqu’il cherche.
Cela dépend de la voie. Par le mode recherche en direct, quelques semaines : dès que le contenu existe et qu’il est trouvable, il peut être cité dans la réponse suivante. Par la mémoire du modèle, des mois, car cela dépend de cycles d’entraînement qui ont lieu quand OpenAI le décide et non quand cela vous arrange. Celui qui vous promet un résultat immédiat sur les deux voies improvise.
C’est le même socle avec un objectif différent. Dans Google, vous optimisez pour un moteur qui affiche dix liens et l’utilisateur choisit. Dans ChatGPT, le moteur donne une seule réponse avec deux ou trois marques à l’intérieur, et celui qui n’en fait pas partie n’existe pas pour cette question. La base technique est commune, c’est pourquoi un site au SEO faible gagne rarement dans l’IA. Ce qui change, c’est qu’il n’y a pas de deuxième page où se placer.
Vous pouvez acheter de la publicité, c’est-à-dire un espace payant identifié comme tel, ce qui est différent d’être recommandé dans la réponse. La publicité dans ChatGPT a ouvert par phases à partir de 2026, et l’achat par des annonceurs hors des États-Unis s’est fait progressivement. La présence méritée dans la réponse n’est toujours pas à vendre, et il vaut la peine de mesurer les deux dans des colonnes séparées pour ne pas confondre l’une avec l’autre.
À lire ensuite
- Votre SaaS B2B n’apparaît pas dans ChatGPT, le même problème vu depuis un secteur.
- Comment apparaître dans Google AI Mode, l’équivalent du côté de Google.
- Ce qu’est l’entity authority, la deuxième étape en détail.